El problema
Consumo mucho contenido técnico en inglés: vídeos, conferencias, reuniones. Las soluciones cloud de transcripción y traducción tienen tres problemas cuando las usas en serio: cobran por minuto, dependen de la red y no te dejan elegir qué audio escuchan.
Quería algo distinto: una app que escuchara lo que suena en mi PC, lo transcribiera en local con la GPU, lo tradujera, me lo leyera en voz alta y bajara el volumen del navegador mientras habla. Sin coste por minuto y sin que el audio saliera de mi máquina.
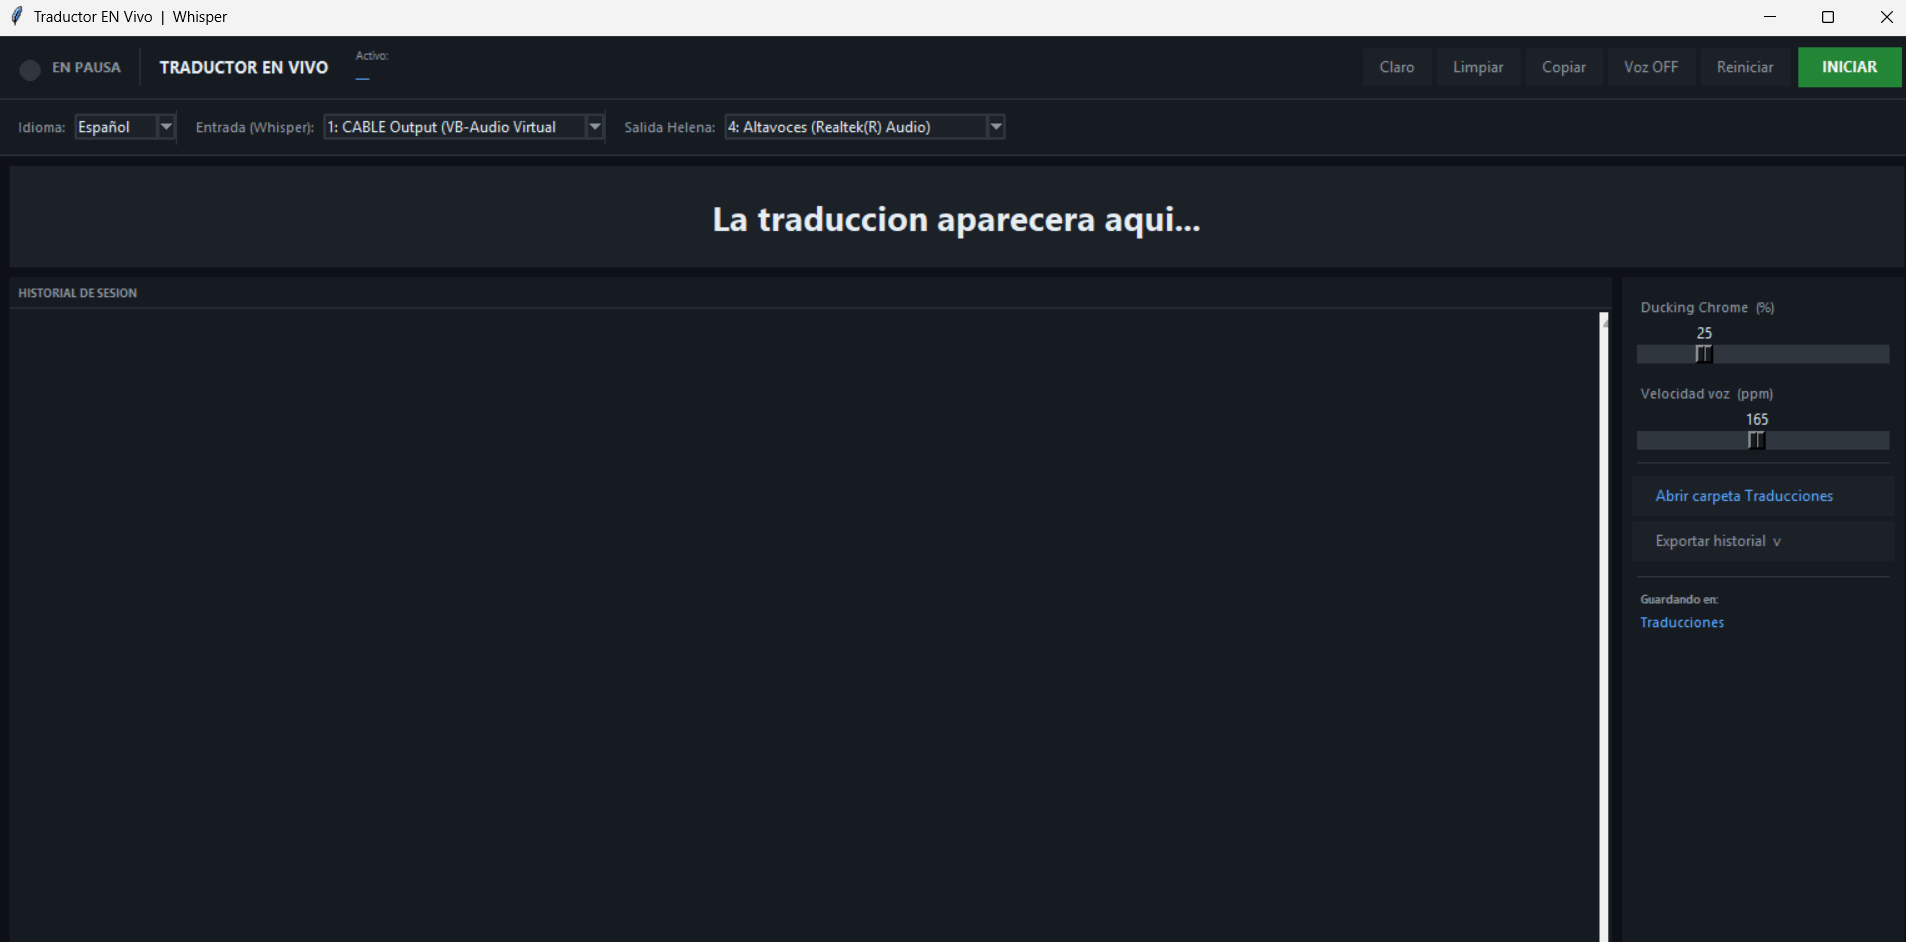
La solución: interfaz
Una app de escritorio para Windows con tres pestañas y un modo pensado para ver vídeos:
- En vivo: traduce lo que suena en el PC (navegador, reuniones, vídeos) a través de un cable de audio virtual. Atajo
Ctrl+Alt+Tpara arrancar o pausar. - Modo cine: una ventana flotante, siempre encima, con subtítulos transparentes sobre cualquier reproductor o plataforma de streaming.
- Vídeo / URL: pego un enlace de YouTube, TikTok, Twitch o Instagram (o un MP4, MKV, MP3 o WAV del disco), lo transcribe con barra de progreso y exporta subtítulos
.srtsincronizados. - Notas Markdown: traduce apuntes o documentación respetando bloques de código y tablas.
- Lector de voz: la voz Helena de Windows sin latencia o voces neuronales de Edge-TTS, con velocidad de 0,5× a 2×. Mientras lee, Chrome, Edge, Firefox y Brave bajan de volumen solos.
- Historial: cada sesión se guarda sola y se exporta a TXT, SRT, DOCX o PDF.
La solución: arquitectura
Salida
Decisiones técnicas
- Cortar por silencios, no por tiempo. La primera versión cortaba el audio cada 5 segundos y partía frases por la mitad, lo que estropeaba la traducción. Con Silero VAD detecto las pausas reales del habla y le paso a Whisper frases completas. Corre en CPU con ONNX, así que no le quita GPU a la transcripción.
- Mi propio motor de Whisper sobre ONNX Runtime. Windows (Control de aplicaciones inteligente) bloqueaba las DLL sin firma de PyTorch y CTranslate2. En vez de renunciar a la GPU, reimplementé el preproceso (el log-mel, en numpy) y la decodificación (voraz, con caché de claves y valores) sobre
onnxruntime-directml, que está firmado por Microsoft. Resultado: transcripción en GPU sin CUDA (vale cualquier GPU con DirectX 12) y sin PyTorch. Elijo el modelo según la VRAM:large-v3-turbo,smallobase. - Traducción local con un LLM pequeño. Un modelo de 1,5B parámetros en Ollama traduce frases conversacionales al instante y sin latencia de red.
- Una cascada que nunca deja la pantalla en blanco. Si Ollama no está abierto o Google bloquea las peticiones, cambio solo a otro traductor (Google, MyMemory o Argos, que funciona sin conexión). La transcripción no se interrumpe nunca.
- Tkinter, no web. Una app web necesitaría el navegador abierto, permisos de audio del navegador y un servidor. Tkinter habla directamente con Windows: lee los dispositivos sin capas intermedias y arranca al instante.
- Ducking con la API de audio de Windows. Con
pycawlocalizo los procesos de los navegadores y les bajo el volumen mientras suena la voz. Cuando termina, lo devuelvo como estaba.
Stack desglosado
- Captura de audio:
sounddevice+numpy, a través de VB-Audio Virtual Cable. - Detección de voz: Silero VAD en ONNX (CPU).
- Transcripción: Whisper (
large-v3-turbo,small,base) sobre ONNX Runtime + DirectML, con mi motor propio (motor_onnx.py). - Traducción: Ollama (
qwen2.5:1.5b) condeep-translator(Google, MyMemory) y Argos Translate de respaldo. - Voz: SAPI5 (voz Helena) y Edge-TTS para voces neuronales.
- Vídeo / URL:
yt-dlp+ FFmpeg. - Interfaz: Tkinter con tema claro y oscuro, búsqueda con
Ctrl+Fy zoom conCtrl+rueda. - Exportación:
python-docx(DOCX),reportlab(PDF), SRT y TXT.
Resultados y aprendizajes
Lo que funcionó: que cada problema real me llevara a una decisión de arquitectura. El mejor ejemplo es el motor propio: cuando Windows bloqueó PyTorch, en lugar de abandonar la GPU reimplementé Whisper sobre ONNX Runtime. Aprendí cómo funciona Whisper por dentro (el espectrograma, el decodificador, la caché) y a elegir dependencias pensando en el entorno donde van a correr.
Lo que más me enseñó: el salto de la v1 a la actual. Empecé con Whisper tiny y cortes fijos de 5 segundos, y cada problema (frases partidas, esperas, caídas de Google, DLL bloqueadas) me obligó a decidir: VAD, motor propio, traducción local y cascada de respaldo. Ninguna salió de un tutorial; todas salieron de usarla.
Trabajo futuro: sacar la configuración a un fichero de entorno, empaquetarla en un instalador y auditarla con kit-iso.