El problema
Un único LLM con un prompt enorme se vuelve frágil enseguida: el contexto crece, las instrucciones se contradicen y cualquier cambio en una parte del flujo rompe otra. La promesa de los frameworks "agénticos" del mercado suele esconder la lógica detrás de cadenas opacas, lo que convierte el debug en arqueología.
Mi objetivo era distinto: una arquitectura donde los agentes estén especializados por dominio, las decisiones sean trazables, el coste por sesión sea predecible y el operador pueda intervenir en cualquier paso. Y, sobre todo, que cambiar de Claude a GPT-4o o a un modelo local con Ollama sea una variable de entorno, no un refactor.
La solución: interfaz
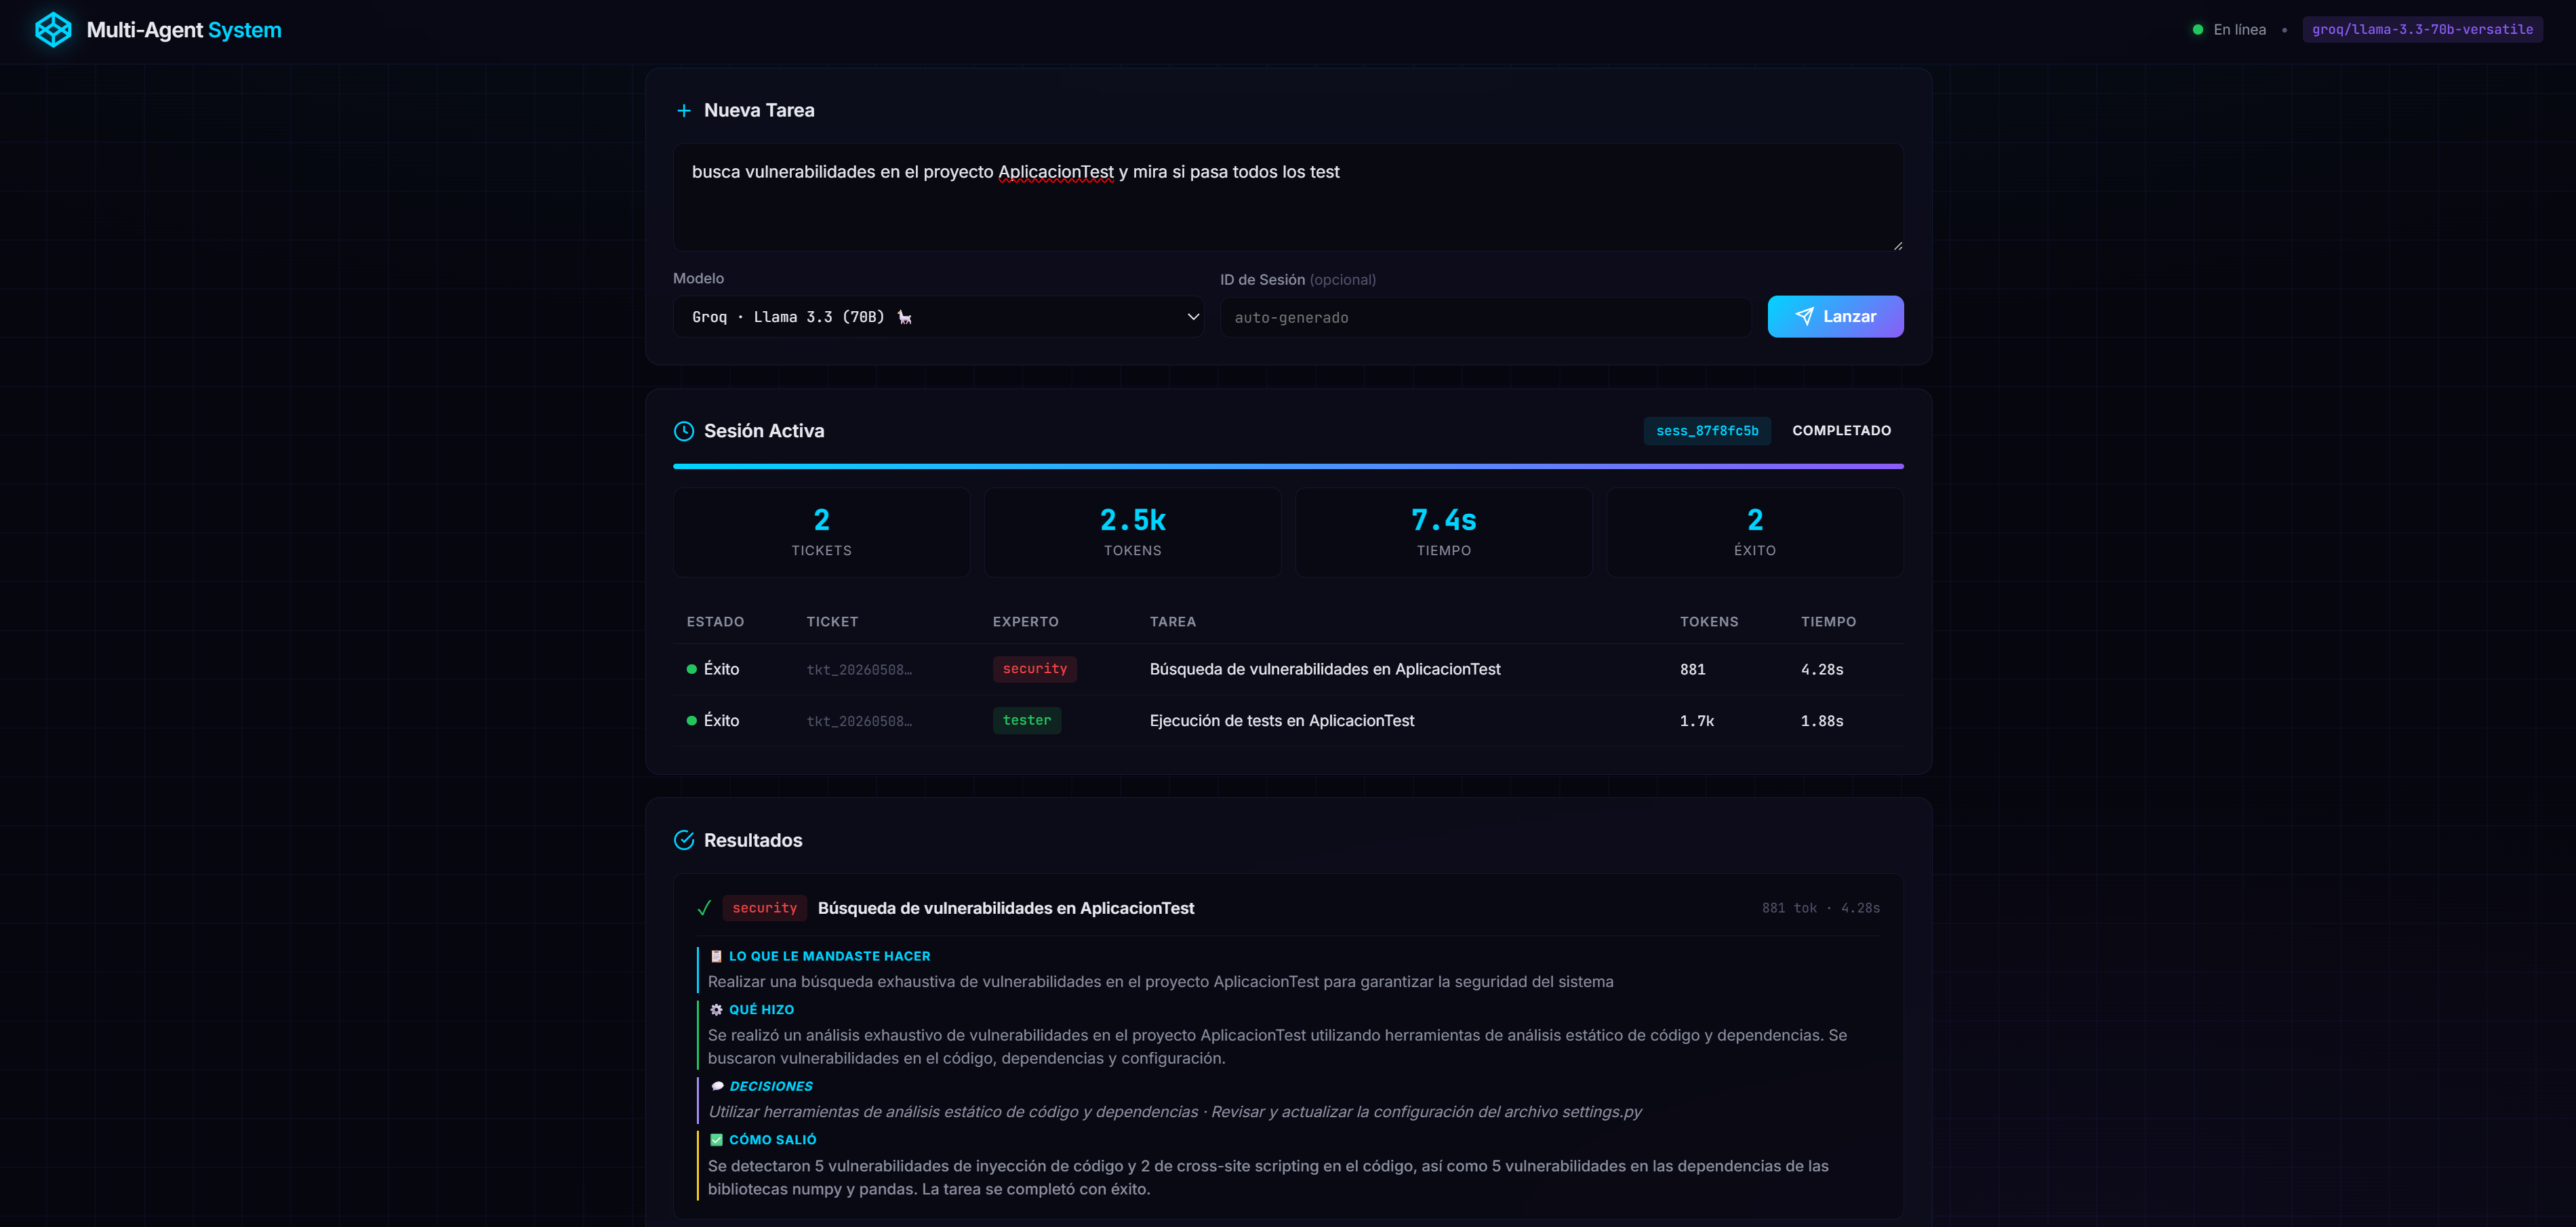
Dos superficies para operar el sistema, ambas conectadas al mismo motor:
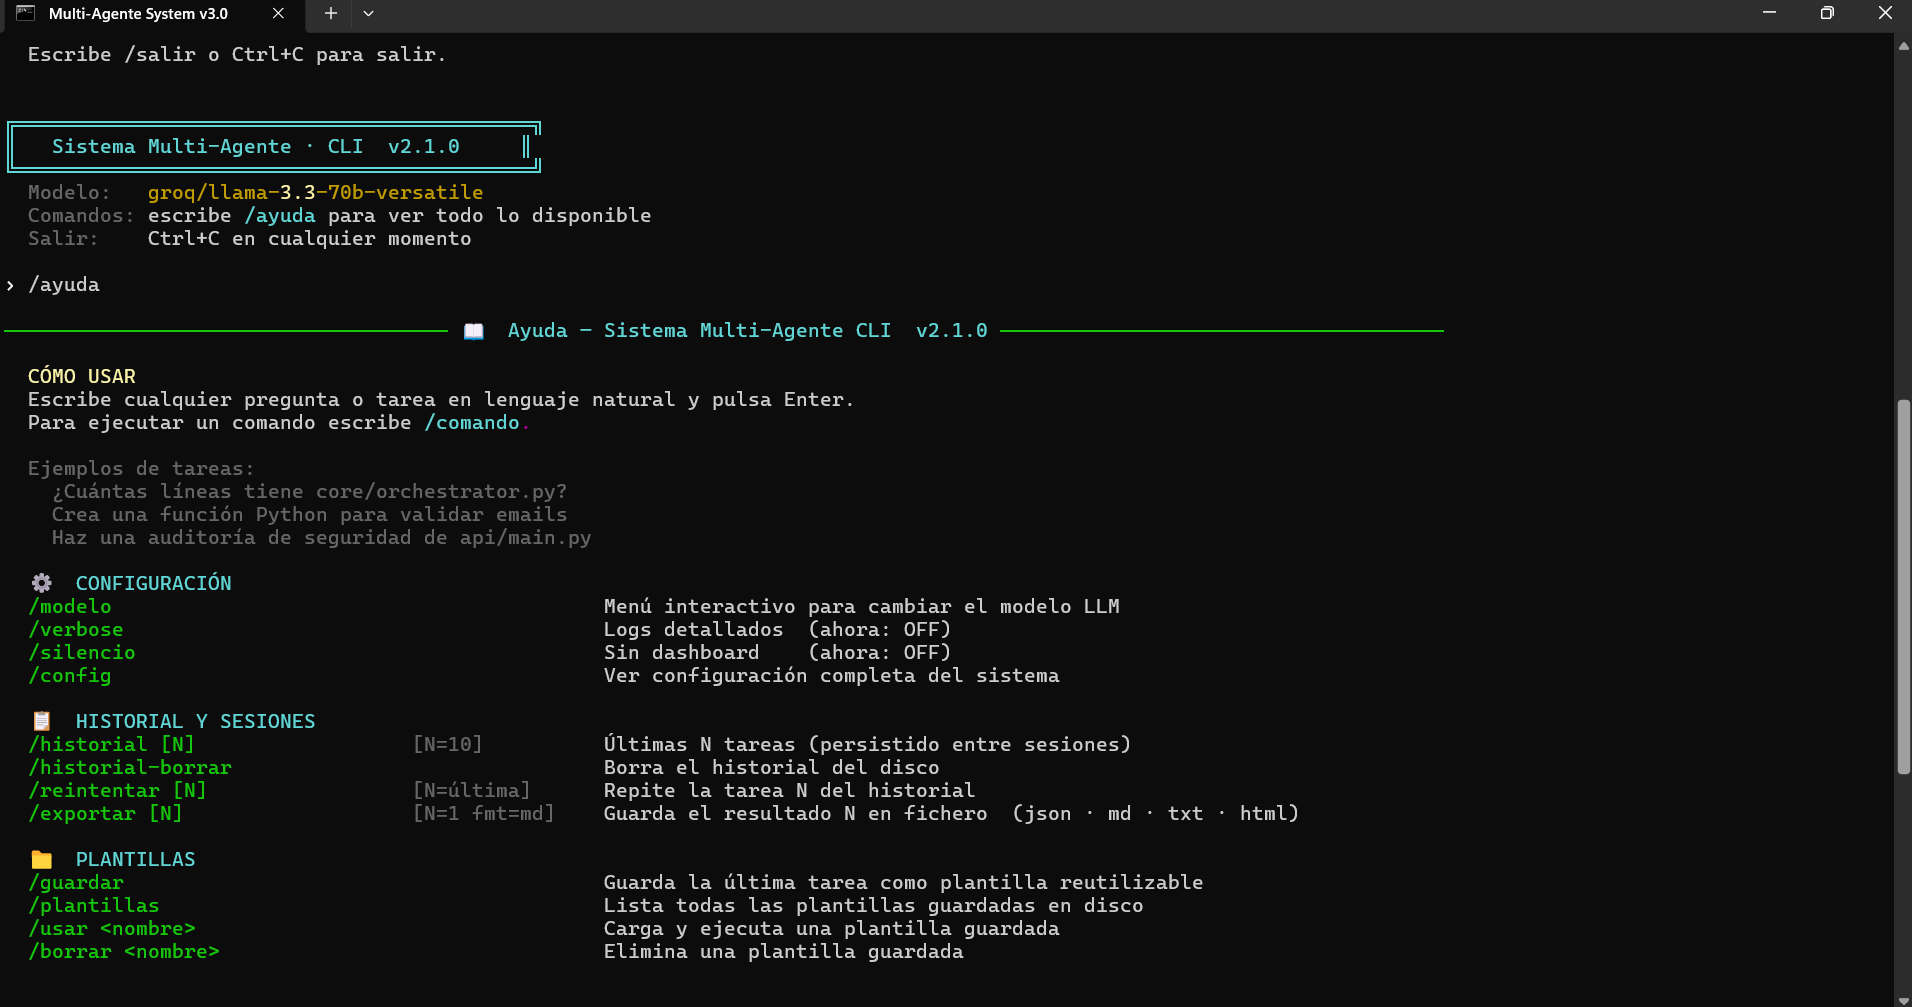
- CLI interactiva (Rich + Typer): REPL con historial, comandos slash (
/ayuda,/historial,/lote,/salir), progreso en tiempo real y modo de tarea única (python cli.py "Crea una API REST para usuarios"). - Dashboard web en tiempo real (FastAPI + WebSocket): visualiza sesiones activas, tickets en curso, métricas de tokens, coste por sesión y handoffs entre agentes. Disponible en
http://localhost:8000.
La solución: arquitectura
┌──────────────────────────────────────────────────────────────┐
│                  Interfaces de entrada                        │
│      CLI (cli.py)        API REST + WebSocket (:8000)         │
└────────────────────────┬─────────────────────────────────────┘
                         │
                         ▼
┌──────────────────────────────────────────────────────────────┐
│                  Orquestador (CEO)                            │
│              core/orchestrator.py                             │
│   Recibe tarea → descompone → genera HandoffTickets           │
└──────┬───────────────────────────────────────────────────────┘
       │  HandoffTickets (1..N)
       ▼
┌──────────────────────────────────────────────────────────────┐
│            Worker Pool (≤3 agentes en paralelo)               │
│                  core/worker_pool.py                          │
└───┬──────────────┬──────────────┬───────────────────────────┘
    ▼              ▼              ▼
┌────────┐   ┌─────────┐   ┌──────────┐
│ Expert │   │ Expert  │   │ Expert   │   (15 tipos disponibles)
│  Dev   │   │  Test   │   │ DevOps   │
└───┬────┘   └────┬────┘   └────┬─────┘
    │              │              │
    ▼              ▼              ▼
┌──────────────────────────────────────────────────────────────┐
│                Herramientas (Tools)                           │
│   Archivos · Código · Tests · Git · Shell · Base de datos    │
└──────────────────────────────────────────────────────────────┘
    │
    ▼
┌──────────────────────────────┐    ┌────────────────────────────┐
│  Redis (estado, sesiones,    │    │  Qdrant (memoria           │
│  rate limiting, PubSub)      │    │  semántica vectorial)      │
└──────────────────────────────┘    └────────────────────────────┘
Interfaces de entrada
15 expertos especializados
Estado y memoria
Los 15 expertos
| Agente | Especialidad |
|---|---|
architect | Diseño de sistemas, patrones, decisiones técnicas |
developer | Generación de código backend/fullstack, APIs |
tester | Estrategias de QA, tests unitarios e integración |
security | Vulnerabilidades, hardening, OWASP |
devops | CI/CD, Kubernetes, Docker, despliegue |
ml_ai | ML/AI, pipelines de datos, modelos |
data_engineer | Pipelines de datos, SQL, ETL |
tech_writer | Documentación técnica, READMEs |
monitoring | Observabilidad, alertas, métricas |
compliance | GDPR, regulaciones, auditorías |
cost_optimization | Optimización de rendimiento y costes cloud |
integrations | APIs, webhooks, integraciones de terceros |
maintenance | Bugs, refactoring, deuda técnica |
uiux | Frontend, UX, diseño responsive |
requirements | User stories, análisis funcional |
Decisiones técnicas
- LiteLLM como capa universal de LLM. Detrás de cada llamada a un modelo no hay SDK de Anthropic, OpenAI ni Google. Hay LiteLLM, que abstrae 60+ proveedores. Cambiar de Claude a Groq o a Ollama local es una env var (
LLM_MODEL=groq/llama-3.3-70b-versatile). Esta decisión salva semanas de migración cuando un proveedor sube precios o saca un modelo nuevo. - Orquestador stateless con HandoffTickets. El CEO (
core/orchestrator.py) no acumula contexto. Recibe la tarea, la descompone en tickets Pydantic tipados (HandoffTicket) y los entrega al Worker Pool. Cada ticket lleva contexto comprimido y prioridad. - Worker Pool con tope de 3 ejecuciones paralelas. Los expertos corren en paralelo, pero nunca más de 3 a la vez. Esto controla rate limit del proveedor LLM y mantiene el coste predecible. Configurable vía
MAX_PARALLEL_AGENTS. - Memoria a dos niveles. Redis para estado runtime (sesiones, tickets en curso, rate limiting, PubSub para WebSocket). Qdrant para memoria semántica a largo plazo (resultados anteriores indexados por similaridad). Mezclar las dos en un mismo backend parece más simple pero acaba siendo lento e inconsistente.
- Control de presupuesto por nivel de agente. Cada agente tiene un techo de tokens. Si lo supera, el ticket falla rápido en vez de reventar el coste. La estimación se hace contra la tabla de precios real del modelo, no aproximada.
- Tools como contrato explícito. Las 6 herramientas (
file_reader,file_writer,code_executor,test_runner,git_tool,shell_executor) heredan detools/base_tool.py. Un experto solo puede llamar las que le declaras enagents_registry.json. Sin manga ancha. - Observabilidad obligatoria, no opcional. OpenTelemetry + structlog en cada llamada a LLM. Cada span lleva tokens de entrada/salida, coste estimado, latencia, modelo y agente. Sin esto el debug es imposible.
- Fallback opcional para Qdrant.
QDRANT_MODE=offlo desactiva. Para entornos sin necesidad de memoria semántica, el sistema sigue funcionando solo con Redis.
Seguridad: de prototipo a sistema endurecido
Un sistema de agentes que lee y escribe ficheros, ejecuta código y lanza comandos es una superficie de ataque enorme, así que lo trato como tal: lo sometí a varias auditorías y lo endurecí por fases, siempre con TDD (primero el test que reproduce el fallo, después el arreglo). Lo que más aprendí vino del testeo en vivo: 34 sesiones con un LLM real sobre una copia aislada y 152 llamadas, que destaparon un bypass de la protección anti-RCE que ningún test unitario veía. Lo reproduje y lo corregí.
Algunos de los controles que implementé:
- Sandbox de código y de shell: bloqueo de imports peligrosos y de
exec/evalanalizando el AST, lista blanca de comandos, y prohibición de ejecutar ficheros que el propio agente acaba de escribir. - Denylist de secretos: ninguna herramienta puede leer
.env, claves ni credenciales, tampoco pasándolas como argumento a un comando. - Grounding obligatorio: si un experto debía leer o crear un fichero y no ejecutó ninguna herramienta, su tarea termina como
PARTIAL, nunca como éxito. El sistema no da por hecho lo que no hizo. - API multiusuario: API keys con scopes
read/full, comparación en tiempo constante, aislamiento de sesiones por propietario, CORS restringido, CSP y HSTS. - Tope de gasto por sesión: un límite agregado de llamadas al LLM corta la sesión antes de que un bucle dispare la factura.
- Integración MCP: los expertos ejecutan acciones reales a través de servidores MCP locales (sistema de ficheros, git y GitHub), con las mismas reglas.
Stack desglosado
- Lenguaje: Python 3.11+, tipado estricto con Pydantic 2.7+.
- API: FastAPI 0.136 + Uvicorn 0.29 (REST + WebSocket en el mismo proceso).
- LLM: LiteLLM 1.35+ (60+ proveedores). Modelos probados: Claude (Anthropic), GPT-4o (OpenAI), Gemini (Google), Llama 3.3 (Groq), Llama 3.2 (Ollama local).
- Estado: Redis 5.0+ para sesiones, rate limiting (RPM/TPM) y PubSub para el WebSocket.
- Memoria: Qdrant 1.9+ con embeddings vía Ollama (
nomic-embed-text, 768 dim) u OpenAI (1536 dim). - CLI: Rich 13.7+ (UI terminal) + Typer 0.12+ (parser de comandos).
- HTTP async: httpx 0.27+.
- Observabilidad: OpenTelemetry + structlog para trazas y logs estructurados.
- Frontend del dashboard: HTML5 + Vanilla JS (sin framework, conecta por WebSocket).
- Tests: pytest 8.2+ con 1.341 tests en suites separadas (unitarios, integración, end-to-end y seguridad).
- Linter: ruff 0.4+.
- Empaquetado: Dockerfile multi-stage con usuario sin privilegios.
- Inicio rápido:
INICIAR_PROYECTO.baten Windows ostart_prod.shen Linux/macOS automatizan venv, dependencias, verificación de servicios y arranque.
Endpoints de la API
| Método | Endpoint | Descripción |
|---|---|---|
POST | /sessions | Crear sesión con una tarea |
GET | /sessions/{id} | Estado de una sesión |
GET | /sessions/{id}/results | Resultados completos |
DELETE | /sessions/{id} | Cancelar sesión |
WS | /ws/sessions/{id} | Feed en tiempo real |
GET | /health | Estado de los servicios |
GET | /metrics | Métricas OpenTelemetry |
Resultados y aprendizajes
Lo que funcionó: apostar por LiteLLM desde el día 1. La capacidad de probar el sistema con Llama 3.3 70B en Groq (gratis para pruebas) y luego subir a Claude Sonnet solo cambiando una env var ha sido una decisión clave. Sin ella, los costes de iteración hubieran sido prohibitivos.
Lo que aprendí: especializar a los expertos por dominio concreto (developer, tester, devops) en vez de por rol abstracto (analista, manager) simplifica drásticamente el prompt de cada uno. Cambiar el comportamiento de un agente no rompe a los demás porque cada uno tiene contrato propio.
Lo que estoy iterando: el sistema de memoria semántica con Qdrant. El recall por similaridad funciona, pero la decisión de cuándo invocar memoria y cuándo confiar en el contexto del ticket sigue abierta. Estoy probando un meta-agente que decide si la query necesita pasada por embedding o no.
Trabajo futuro: exportar el grafo de la sesión como SVG embebible, soporte de pausa/reanudar a mitad de ejecución, y un módulo de auditoría para integrar con el Kit Cumplimiento ISO (especialmente ISO 42001 sobre IA responsable).